
Paper: Consistency-guided Prompt Learning for Vision-Language Models
ar5iv: HTML version
Abstract
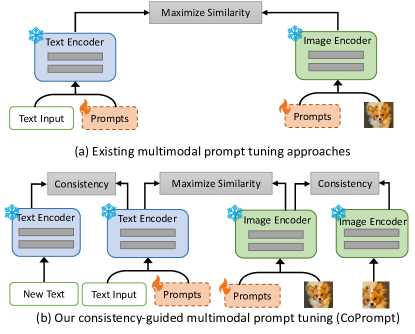
CoPrompt는 CLIP 같은 vision-language foundation model을 few-shot downstream task에 맞게 적응시키면서도, 원래 모델이 갖고 있던 zero-shot generalization 을 최대한 잃지 않도록 설계한 방법이다. 논문의 핵심 문제의식은 명확하다. 기존 prompt tuning이나 adapter tuning은 downstream few-shot 성능은 높일 수 있지만, 학습 가능한 파라미터가 적은 데이터에 과적합되면서 pre-trained CLIP의 표현 공간에서 너무 멀어지기 쉽다.
그래서 CoPrompt는 trainable model의 image/text embedding이 frozen pre-trained CLIP의 embedding과 지나치게 멀어지지 않도록 consistency constraint 를 건다. 여기에 두 가지를 더한다.
- 동일 입력이 아니라 perturbed input 사이에서 consistency를 맞춰 regularization을 강화
- prompt와 adapter를 함께 써서 downstream 적응력 자체는 유지
즉 CoPrompt는 “더 많은 파라미터를 열어도 generalization이 무너지지 않게 만드는 tuning 전략”이라고 보면 된다.
논문이 주장하는 핵심 메시지는 다음 한 줄로 정리된다.
few-shot adaptation이 필요하더라도, trainable model이 pre-trained CLIP의 표현 공간에서 너무 멀어지지 않게 제어하면 generalization을 더 잘 유지할 수 있다.
Method
1. 기본 출발점
CoPrompt의 backbone은 CLIP이다. 기존 CoOp, CoCoOp, MaPLe처럼 frozen CLIP 위에 learnable prompts를 붙여 downstream task에 맞춘다. 다만 CoPrompt는 여기서 한 단계 더 나간다. prompt만 넣는 것이 아니라 adapter 도 추가하고, 그 학습 과정 전체를 consistency로 규제한다.
논문은 특히 MaPLe의 multi-modal prompting을 backbone으로 삼는다. 즉 image branch와 text branch 모두에 learnable context를 넣는 구조 위에서 CoPrompt를 설계한다.
2. Consistency Constraint
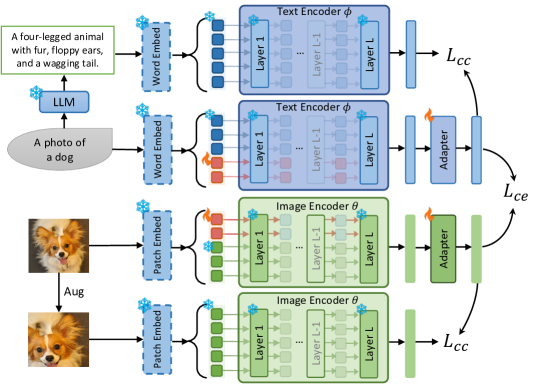
가장 중요한 구성요소는 consistency loss다. trainable model의 embedding이 frozen pre-trained CLIP의 embedding에서 크게 벗어나지 않도록, image/text 양쪽 모두에서 consistency를 건다.
개념적으로는 다음처럼 볼 수 있다.
\[\mathcal{L}_{\text{cons}} = \mathcal{D}(f_{\text{train}}(x), f_{\text{frozen}}(\tilde{x})) + \mathcal{D}(g_{\text{train}}(t), g_{\text{frozen}}(\tilde{t}))\]여기서
- (f_{\text{train}}, g_{\text{train}}): prompt와 adapter가 붙은 학습 모델
- (f_{\text{frozen}}, g_{\text{frozen}}): 고정된 pre-trained CLIP
- (\tilde{x}, \tilde{t}): perturbed image/text 입력
- (\mathcal{D}): embedding distance
논문에서는 cosine distance가 가장 잘 맞았다고 보고한다. 즉 크기보다 표현 방향을 보존하는 것이 더 중요하다는 뜻이다.
3. Input Perturbation
CoPrompt가 단순 distillation과 다른 점은 teacher와 student가 완전히 같은 입력을 보지 않는다는 것이다.
- text branch: 기본 템플릿
a photo of a [class]대신, GPT가 만든 더 descriptive한 문장을 frozen encoder에 넣는다. - image branch: 원본 이미지 대신 augmentation된 이미지를 frozen encoder 쪽 입력으로 사용한다.
이렇게 하면 consistency가 단순 복제가 아니라, 의미는 같지만 표현은 조금 다른 입력들 사이의 invariance 를 배우는 regularizer가 된다.
4. Prompt + Adapter 결합
prompt는 입력 공간을 조정하고, adapter는 내부 표현을 조정한다. 문제는 두 개를 같이 쓰면 few-shot에서는 오히려 overfitting이 더 심해질 수 있다는 점이다. CoPrompt는 consistency constraint를 붙여서 이 문제를 막는다. 즉 이 논문에서 adapter의 성능 향상은 adapter 자체보다, consistency가 더 많은 파라미터 학습을 안전하게 만들어줬기 때문에 가능했다고 보는 편이 맞다.
최종 objective는 supervised classification loss와 consistency loss의 합으로 쓸 수 있다.
\[\mathcal{L}_{\text{final}} = \mathcal{L}_{\text{CE}} + \lambda \mathcal{L}_{\text{cons}}\]여기서 (\lambda) 는 task adaptation과 representation preservation 사이의 균형을 조절한다.
5. 방법의 핵심 해석
CoPrompt를 가장 잘 이해하는 방법은 이렇다.
- prompt: downstream task에 맞는 입력 문맥을 학습
- adapter: 더 강한 적응 능력을 확보
- consistency: 그 적응이 pre-trained CLIP의 일반화 표현을 망가뜨리지 않도록 제어
즉 CoPrompt는 단순 prompt tuning이 아니라, regularized multi-modal adaptation 에 가깝다.
Result
1. Base-to-Novel Generalization
가장 대표적인 결과는 11개 recognition dataset 평균이다. 논문에 따르면 CoPrompt는 MaPLe 대비
- Novel accuracy:
75.14 -> 77.23(+2.09) - Harmonic Mean:
80.48수준으로 개선 (+1.93) - Base accuracy:
+1.72개선
즉 CoPrompt는 “novel class 성능을 높이려다 base class를 잃는” 문제가 아니라, base와 novel을 함께 개선한 것이 핵심이다. 이는 기존 CoOp 계열에서 자주 보이던 overfitting 양상과 대비된다.
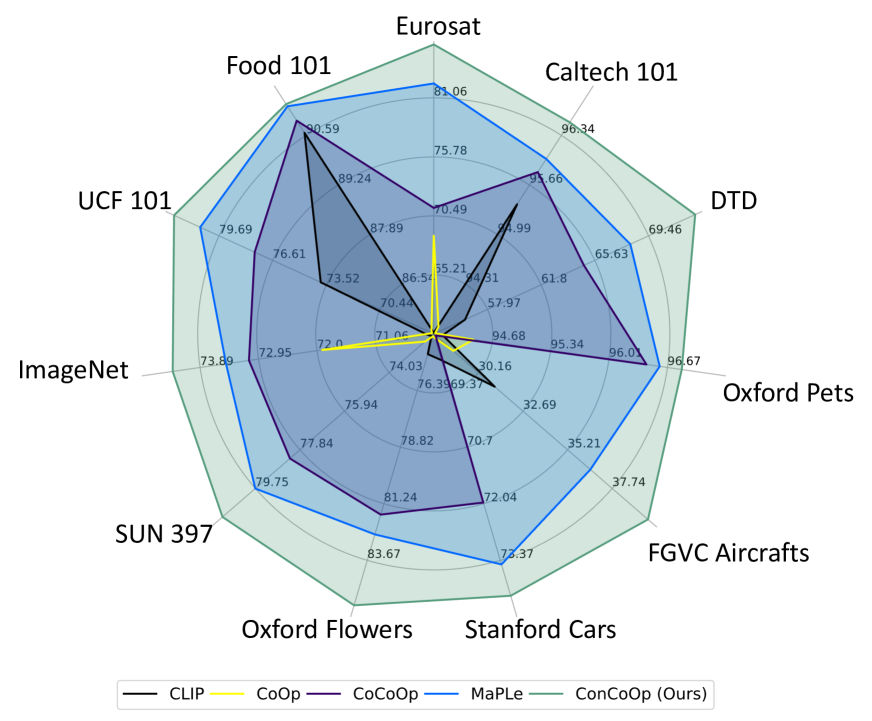
논문은 특히 CoPrompt가 11개 데이터셋 전반에서 MaPLe보다 더 안정적으로 높은 harmonic mean을 보인다고 강조한다. 즉 few-shot 성능과 zero-shot 일반화 사이의 trade-off를 완화한 셈이다.
2. Cross-dataset Evaluation
ImageNet few-shot으로 학습한 모델을 다른 10개 데이터셋에 그대로 평가한 cross-dataset setting에서도 CoPrompt는 평균 67.0% 를 기록해 MaPLe의 66.30% 를 넘어선다. 숫자 차이는 크지 않지만, 이 setting은 overfitting이 심하면 바로 무너지는 실험이기 때문에 의미가 있다.
이 결과는 CoPrompt의 consistency constraint가 단순히 training set 내부 regularization이 아니라, 새 데이터셋에서도 유지되는 표현 보존 장치로 작동한다는 점을 보여준다.
3. Domain Generalization
ImageNet에서 학습한 뒤 ImageNetV2, ImageNet-Sketch, ImageNet-A, ImageNet-R에 평가한 domain generalization 실험에서도 CoPrompt는 평균 60.43% 로 MaPLe의 60.26% 보다 높다. 특히 ImageNet-A를 제외한 대부분의 타깃 분포에서 개선을 보인다.
폭 자체는 크지 않지만, 이 논문의 요점은 “모든 setting에서 압도적으로 크다”보다, prompt와 adapter를 더 적극적으로 써도 generalization이 무너지지 않는다는 데 있다.
4. Ablation 해석
논문에서 가장 설득력 있는 부분은 ablation이다.
- adapter를 제거하면 성능이 떨어진다.
- input perturbation을 제거해도 성능이 떨어진다.
- consistency 없이 prompt+adapter만 학습하면 성능이 더 크게 떨어진다.
특히 consistency 없이 adapter까지 같이 학습하면, 아예 세 구성요소를 다 뺀 것보다도 성능이 낮아진다. 이건 CoPrompt의 핵심이 adapter나 prompt 자체가 아니라, 그 둘을 안정적으로 묶어주는 consistency 설계라는 점을 강하게 보여준다.
추가 분석도 흥미롭다.
- text-only consistency가 image-only consistency보다 더 중요하게 작동
- same input보다 GPT descriptive sentence / simple augmentation이 더 좋음
- cosine distance가 MSE, L1보다 가장 안정적
즉 CoPrompt는 “강한 모델을 더 많이 학습하자”가 아니라, 학습된 모델이 pre-trained 의미 공간을 유지하도록 정교하게 유도하자는 논문이다.
정리
CoPrompt의 핵심은 overfitting을 정면으로 다룬다는 데 있다. 기존 prompt tuning 논문들이 주로 “어디에 prompt를 넣을까”를 고민했다면, CoPrompt는 그보다 더 근본적인 질문을 던진다.
few-shot에서 새 파라미터를 학습할 때, 왜 generalization이 망가지는가?
그리고 그 답을 pre-trained CLIP의 표현 공간에서 너무 멀어지는 것으로 해석하고, consistency constraint로 이를 제어한다.
한 문장으로 요약하면 이렇다.
CoPrompt는 prompt와 adapter를 함께 학습하되, trainable model의 image/text embedding이 frozen CLIP의 embedding과 일관성을 유지하도록 만들어 few-shot 적응과 zero-shot 일반화를 동시에 잡으려는 방법이다.
이 논문이 좋은 이유는 설계 논리가 선명하다는 점이다. prompt, adapter, perturbation, consistency가 따로 놀지 않고 하나의 가설 아래 묶여 있다. CoOp, CoCoOp, MaPLe 이후 흐름에서 보면 CoPrompt는 단순 성능 개선 논문이 아니라, prompt tuning의 과적합 문제를 어떻게 제어할 것인가에 대한 꽤 직접적인 해답으로 읽힌다.